CSAT и Time-to-Market в Пульте
Пульт — внутренняя CMS Звука для музыкальной редакции: контент-менеджеров, музыкальных редакторов и экспертов. У команды не было способа понять, стало ли редакции лучше после релиза: был только факт выкатки, без обратной связи.
Контекст
Один из разделов Пульта, «Гриды», переезжает с legacy-бэкофиса на новую CMS. Выходят новые фичи — клонирование секций и переход на грид по ссылке или QR-коду, — но способа проверить, стало ли редакции реально лучше, нет: только факт релиза, без обратной связи.
Роль и период
Product/UX-дизайнер, Q2 2026. Разработал методологию измерения и провёл сбор обратной связи самостоятельно.
Задача
У команды не было метрики, которая отвечала бы на вопрос «стало лучше или просто выкатили». Нужен был лёгкий, повторяемый способ после каждого релиза проверять три вещи: реально ли фича помогает, сократился ли ручной труд и время задачи, не сломался ли UX — и превращать эти ответы в цифру, понятную бизнесу.
Методология
Спроектировал разовый точечный опрос вместо постоянных pulse-опросов: CSAT снимается через 5–10 рабочих дней после релиза, когда редакция успела попользоваться фичей. Каждое решение — по схеме «проблема → решение → почему».
Метрика: CSAT по шкале 4–5
Нет числа, по которому можно судить, стало ли лучше: вместо оценки — впечатления в чатах.
CSAT — доля ответов 4–5 по вопросу «насколько вы довольны изменением X». Порог успеха — не ниже 75%.
Одна цифра, понятная и редакции, и бизнесу; порог задан заранее, поэтому результат нельзя подогнать.
Ускорение задачи: «до / после» в одной анкете
Ускорение обычно заявляют, но не измеряют, а сравнивать с «как было» приходится по памяти.
В той же анкете респондент указывает, сколько времени задача занимала до и занимает после. Эффект считается по медиане: Acceleration = median(до) / median(после).
Медиана не искажается одним-двумя выбросами, а сравнение делается одним человеком в одном опросе.
Снижение ручного труда
Та же логика через число шагов и действий и субъективную трудоёмкость по шкале 1–5.
Время задачи не показывает, стало ли меньше рутины: сокращение шагов — отдельная выгода фичи.
Кого опрашивать
Только тех, кто реально работал с фичей за последние N дней, а не «на слух». Если редакция маленькая — опрашивать всех.
Оценка от тех, кто фичей не пользовался, размывает результат и занижает или завышает CSAT.
Опросник на 2–3 минуты
Форма в Google Forms из пяти блоков: фильтр участия → CSAT и сравнение с Backoffice → ускорение → ручной труд → причины и открытый фидбек, который уходит в backlog.
Короткий опрос не мешает работе редакции, а открытый блок превращает ответы в задачи, а не только в цифру.
Обкатка на двух фичах «Гридов»
Методологию проверили на двух фичах раздела «Гриды»:
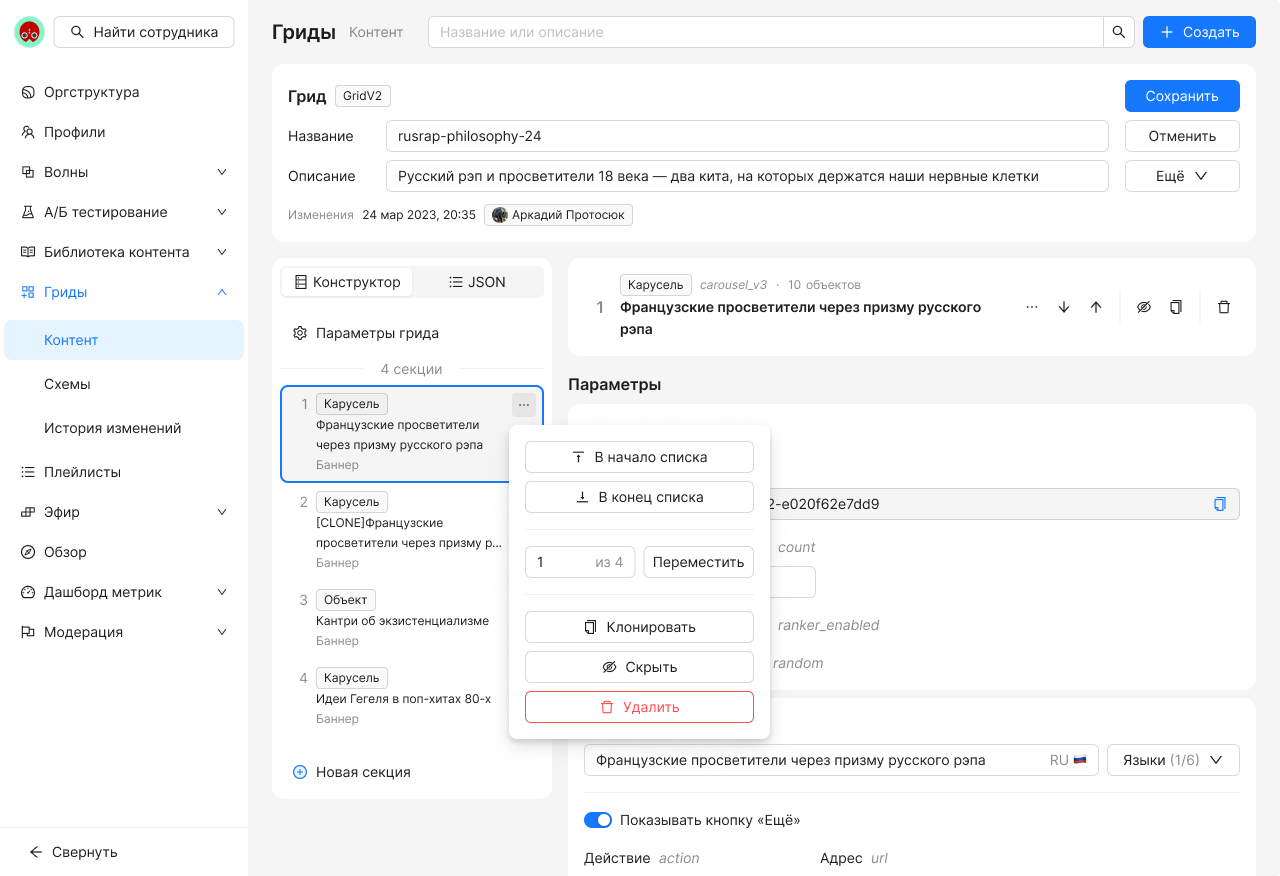
- клонирование секции — копия секции грида внутри Пульта вместо сборки с нуля;
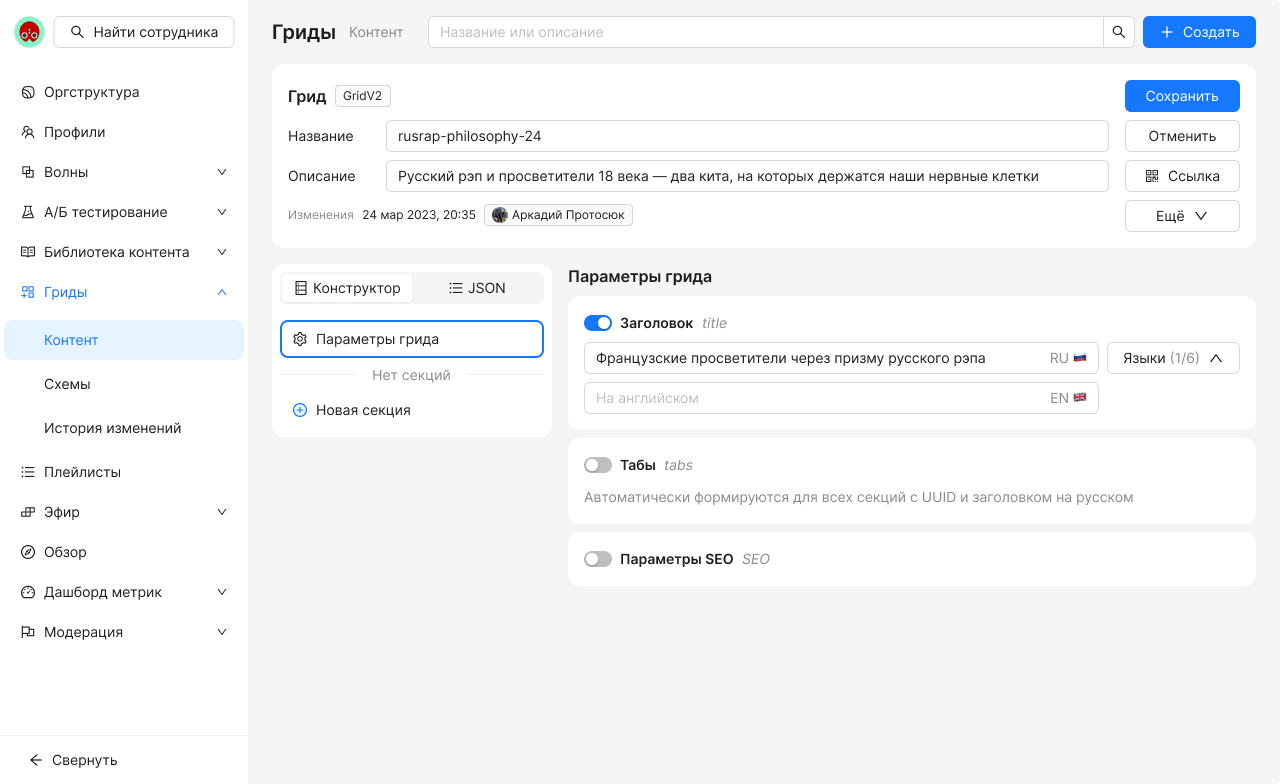
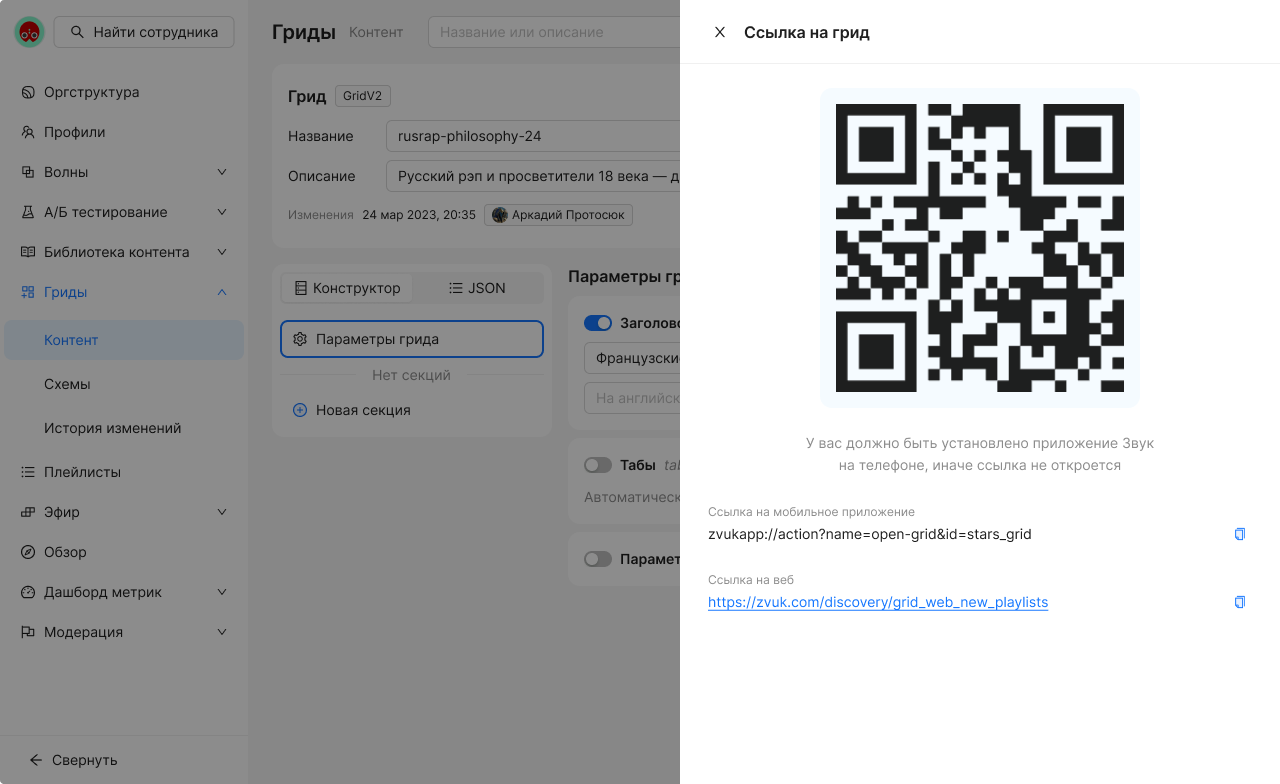
- переход на грид по QR-коду или диплинку — быстрый вход в нужный грид без поиска по списку.
Клонирование секции
Переход на грид по QR-коду / диплинку
Окно со ссылкой на грид
Результат
CSAT по обеим исследованным фичам — 100%, средняя оценка 5,0 из 5 по 11 ответам редакции.
Субъективно оцениваемое время задачи сократилось на 50% (клонирование секций) и на 80% (переход по QR-коду или диплинку). Цель по снижению Time-to-Market — не менее 20% — превышена в 2,5–4 раза.
Это оценка самих пользователей, а не замер таймером, а выборка небольшая — 11 ответов из редакции.
Методология зафиксирована как многоразовый шаблон: применяется после каждого релиза в «Гридах», дальше её планируют тиражировать на модерацию, лицензирование и библиотеку контента.